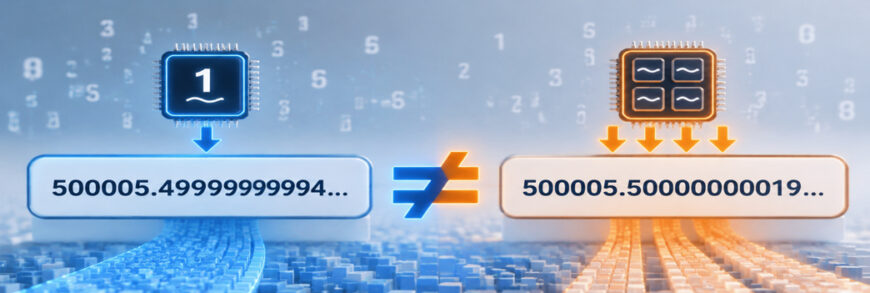
Когда начинаешь плотно заниматься распараллеливанием процессов всплывает много интересных нюансов. И первые грабли лежат на поверхности — это классическая гонка данных (data race), когда несколько потоков одновременно лезут менять одну переменную. Ставим локальные аккумуляторы или прикрываемся критической секцией (TCriticalSection), проверяем — память не бьётся, артефактов нет. Кажется, победа. Но…
Но во время работы над циклом Быстрый и кроссплатформенный блюр: VCL, FMX, LCL всплыл куда более интересный и коварный сюжет. Дело в том, что значения сумм, посчитанные в одно- и многопоточной версии могут отличаться! Мы честно синхронизируем потоки, гонки данных нет, каждый элемент массива учтён ровно один раз, а итоговый результат от запуска к запуску слегка «плывёт». Даже если в самом конце стоит обычный Round.
Это происходит не всегда, но всё же иногда происходит. И это касается только операций над числами с плавающей точкой. Пришлось сесть за разбор полётов.
Математика против IEEE 754
В начале вспомним общеизвестный факт, который настолько привычен, что уже подзабылся.
В обычной математике сложение ассоциативно: (a+b)+c = a+(b+c). Как ни переставляй скобки, сумма не изменится. В стандарте чисел с плавающей точкой IEEE 754 (Single, Double) это правило не работает.
Причина в самом устройстве мантиссы и экспоненты. У Double под мантиссу отведено 52 бита в памяти (53 бита точности с учётом неявного старшего бита), это около 15–17 значащих десятичных цифр. Когда процессор складывает два числа разных порядков, например, накопленную сумму 5 000 000.0 и очередной маленький вес 0.00001, ему приходится выравнивать экспоненты, сдвигая мантиссу меньшего числа вправо. Младшие биты при этом просто выпадают за разрядную сетку и округляются.
Поэтому мы порой и видим в результате замысловатых вычислений вместо математически правильного числа 5.0 что-то наподобие 4.99999999994. Где-то что-то отсеклось в процессе накопления суммы.
Наглядно этот эффект виден на простом примере с ограниченной разрядной сеткой:
Требуется сложить два числа: 3.5 и 1.125 с точностью 3 бита после запятой.
3.5 + 1.125 = (1+3/4)*21 + (1+1/8)*20
Выравниваем экспоненты (20 ->21, сдвигаем мантиссу второго числа вправо):
(1+3/4)*21 + (1/2+1/16)*21
Но у нас точность 3, то есть минимум для данного примера 1/8. Таким образом 1/16 обрезается.
(1+3/4+1/2) *21 = (2+1/4) *21 = (1+1/8) *22 = 4.5
А должно быть 4.625. «Где-то что-то отсеклось…».
Подсмотрено тут.
Хорошо, с двумя числами всё ясно. Но у нас другой случай: есть большой массив данных, один на все измерения. Если считаем сумму его элементов в одном потоке, то получаем один результат. Запускаем многопоточную версию на тех же самых данных — сумма немного другая:

|
1 2 3 4 5 |
Serial : 500005,499999999940000 -> Round: 500005 Parallel : 500005,500000000320000 -> Round: 500006 Serial : 500005,499999999940000 -> Round: 500005 Parallel : 500005,499999999940000 -> Round: 500005 |
То, что при накоплении суммы отсекаются младшие биты мантиссы — неизбежное зло, мы это понимаем и прощаем. Вопрос в другом: почему многопоточная версия на одном и том же массиве при каждом новом запуске выдаёт разный результат — то 500005, то 500006? Неужели мы снова наступили на грабли с гонкой данных?
Стенд: Ловим парадокс в консоли
В обычном коде микроотклонение в 12–15 знаке после запятой легко не заметить. Чтобы сделать эффект максимально наглядным и превратить невидимый шум мантиссы в явное расхождение целых чисел, собрал небольшой консольный стенд FloatParallelParadox.
Идея простая, считаем массив по формуле:

Сумма этой арифметической прогрессии = 500005.0. И добавляем в нулевой элемент базу 0.5. Итоговая математическая сумма теперь равна 500005.5. Мы ставим вычисления точно на лезвие банковского округления Round.
|
1 2 3 4 5 6 7 8 |
const COUNT = 100000; ... // Инициализация данных SetLength(Data, COUNT + 1); Data[0] := 0.5; // Базовое число, балансирующее ровно на грани округления for I := 1 to COUNT do Data[I] := 10*I/COUNT; |
Однопоточная версия
Однопоточная версия просто бежит по циклу и суммирует :
|
1 2 3 4 5 6 7 8 |
procedure SerialSum(const Data: TDoubleDynArray; out Result: Double); var I: Integer; begin Result := 0; for I := 0 to High(Data) do Result := Result + Data[I]; end; |
Многопоточная версия
В многопоточной версии мы аккуратно защищаем накапливаемую сумму через критическую секцию, никакой гонки данных здесь нет. Поэтому версию про некачественную работу с потоком отбрасываем. Мы уже напоролись раз на подобную ситуацию, больше не хотим.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 |
procedure ParallelSum(const Data: TDoubleDynArray; out Result: Double); var D: TDoubleDynArray; Lock: TCriticalSection; Sum: Double; begin Lock := TCriticalSection.Create; try D := Data; Sum := 0; TParallel.For(0, High(D), procedure(Index: Integer) var W: Double; begin W := D[Index]; Lock.Enter; try Sum := Sum + W; finally Lock.Leave; end; end); finally Lock.Free; end; Result := Sum; end; |
Гипотеза такая. Пока цикл однопоточный, порядок слагаемых железобетонный: от 0 до N. Ошибки округления накапливаются по строго одной и той же траектории, и результат детерминирован до последнего бита.
Как только мы включаем TParallel.For (или любой другой динамический пул потоков), порядок исчезает. Потоки разбирают итерации по мере освобождения ядер: один поток чуть притормозил на прерывании ОС, другой проскочил быстрее — и вот порядок входа в сумматор уже другой. Погрешность в 15-м знаке после запятой начинает гулять.
Чтобы проиллюстрировать небольшой пример:
Эффект крупной рыбы:
Представьте, что нам нужно просуммировать миллион мелких показаний по 0.00001 (в сумме это ровно 10.0) и добавить к ним один крупный выброс — 100.5. Идеальный математический ответ: 110.5.
Если складывать строго по порядку — сначала миллион мелких чисел, а 100.5 прибавить в самом конце, мелочь успеет накопиться в весомые 10.0, и мы получим точные 110.5.
А теперь раздадим эту задачу четырём потокам (TParallel.For). Поток, которому досталось 100.5, начнёт прибавлять к нему мелкие 0.00001 по одной штуке и большое число на каждом шаге будет «откусывать» младшие биты мантиссы у мелкого. На выходе вместо 110.5 получится, скажем, 110.49999. Для глаза разницы нет, но стоит в конце вызвать Round, как 110.5 превратится в 110, а если число качнётся в 110.50001, то результат станет 111.
Чтобы проверить гипотезу, рассмотрим способы вылечить конкретно эту проблему — потерю данных мантиссы при встрече чисел разного порядка, где порядок слагаемых решает всё. Если вылечим проблему — значит, гипотеза верна.
Теория: Как решать эту проблему
Выбор лекарства зависит от того, что для нас важнее — скорость и простота или строгая повторяемость результата.
Способ 1: Уйти в целочисленную арифметику (Fixed-Point)
Сложение целых чисел строго ассоциативно. Сколько ни переставляй слагаемые местами, пока нет переполнения разрядной сетки, сумма останется побитово идентичной.
Именно по этому пути мы пошли при разгоне алгоритмов в проекте по блюрам: перевод весов на Fixed-Point дал и абсолютный детерминизм, и кратный прирост скорости по сравнению с Double.
Способ 2: Детерминированная редукция по чанкам (без Lock в цикле)
Если без плавающей точки никак (например, считаем сложные вещественные веса в нейросетевом фильтре или геометрические интегралы), нельзя сваливать результаты в общую кучу в произвольном порядке.
Решение — фиксированное дерево редукции:
- Делим диапазон 0..COUNT на NumChunks фиксированных кусков (например, по числу логических ядер CPU).
- Каждый поток считает свой кусок строго последовательно в свой личный элемент массива PartialSums[ChunkIdx]. Никаких критических секций внутри цикла вообще нет.
- После завершения всех потоков главный поток в цикле for I := 0 to NumChunks — 1 складывает эти NumChunks частичных сумм строго по порядку.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 |
var NumChunks, ChunkSize, I: Integer; PartialSums: array of Double; begin NumChunks := TThread.ProcessorCount; SetLength(PartialSums, NumChunks); ChunkSize := (COUNT + 1 + NumChunks - 1) div NumChunks; TParallel.For(0, NumChunks - 1, procedure(ChunkIdx: Integer) var I, StartIdx, EndIdx: Integer; LocalSum: Double; begin StartIdx := ChunkIdx * ChunkSize; EndIdx := Min(StartIdx + ChunkSize - 1, COUNT); LocalSum := 0; for I := StartIdx to EndIdx do LocalSum := LocalSum + Data[I]; PartialSums[ChunkIdx] := LocalSum; end); SumParallel := 0; for I := 0 to NumChunks - 1 do SumParallel := SumParallel + PartialSums[I]; end; |
Что здесь происходит. Две вещи. Первое, внутри каждого потока мы идём строго по нарастанию индекса внутри своего чанка, этим и определяется строгая детерминированность процесса. Второе – наш массив данных строго возрастает, поэтому неожиданная встреча сильно разных значений исключается.
Итоговые результаты мы также складываем по нарастанию значений, потеря бита возможна, но маловероятна. Но если нужен более тщательный подход, нам понадобится компенсирующий алгоритм Кэхэна.
Способ 3: Компенсированное суммирование (алгоритм Кэхэна)
Если нужен не просто детерминизм, а ещё и максимальная математическая точность (чтобы SerialSum и ParallelSum не теряли хвост при сложении чисел разного порядка), внутри каждого чанка и при финальной сборке будем использовать алгоритм Кэхэна (Kahan summation), который заводит дополнительную переменную для улавливания «потерянных» при округлении младших битов и возвращает их на следующей итерации.
Данный способ не даёт стопроцентной гарантии точности. Как только встретятся данные с оглушительной разницей в порядке, сломается точность. Но всё ж таки в большинстве случаев он работает. Подробнее чуть ниже.
Практика: Проверяем решения на замерах
Целочисленная арифметика подробнейшим образом разобрана в статьях цикла. Поэтому тут рассмотрим два подхода: детерминированность чанков и компенсацию Кэхэна. И их комбинацию.
Parallel Chunk: Чанки по числу ядер
Делаем ровно то, что описали чуть выше:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 |
procedure ParallelChunkSum(const Data: TDoubleDynArray; out Result: Double); var NumChunks, ChunkSize, I: Integer; PartialSums: array of Double; SumFinal: Double; D: TDoubleDynArray; begin D := Data; NumChunks := TThread.ProcessorCount; SetLength(PartialSums, NumChunks); ChunkSize := (High(Data) + 1 + NumChunks - 1) div NumChunks; // Каждый поток считает свой чанк локально TParallel.For(0, NumChunks - 1, procedure(ChunkIdx: Integer) var Idx, StartIdx, EndIdx: Integer; LocalSum: Double; begin StartIdx := ChunkIdx * ChunkSize; EndIdx := Min(StartIdx + ChunkSize - 1, High(D)); LocalSum := 0.0; for Idx := StartIdx to EndIdx do LocalSum := LocalSum + D[Idx]; // Пишем в свою личную ячейку - гонки и false sharing минимальны PartialSums[ChunkIdx] := LocalSum; end); // Главный поток собирает итог строго по порядку SumFinal := 0.0; for I := 0 to NumChunks - 1 do SumFinal := SumFinal + PartialSums[I]; Result := SumFinal; end; |
Получаем такой результат:
|
1 2 3 4 5 6 7 8 |
Parallel : 500005,500000000060000 -> Round: 500006 (time: 352,15 ms) Parallel Chunk : 500005,500000000000000 -> Round: 500006 (time: 0,18 ms) Parallel : 500005,499999999870000 -> Round: 500005 (time: 59,64 ms) Parallel Chunk : 500005,500000000000000 -> Round: 500006 (time: 0,17 ms) Parallel : 500005,500000000190000 -> Round: 500006 (time: 23,32 ms) Parallel Chunk : 500005,500000000000000 -> Round: 500006 (time: 0,17 ms) |
Результат, прямо скажем, очень приятный на глаз.
Здесь мы убиваем сразу двух зайцев: исчезает узкое место в виде TCriticalSection (код начинает летать в полную силу всех ядер), и порядок сложения становится 100% детерминированным от запуска к запуску (при фиксированном NumChunks).
Гипотеза полностью подтвердилась. Как только мы зафиксировали порядок сложения внутри каждого чанка и при финальной сборке, расхождение исчезло начисто: от запуска к запуску результат стоит как вкопанный, а Round перестал прыгать. Значит, дело действительно было не в синхронизации потоков, а в неассоциативности Double при случайном порядке слагаемых.
Обратите внимание: исчезновение критической секции даёт мощный выигрыш в скорости в 137-350 раз (23,32-59,64 ms против 0,17 ms). Этот факт нам пригодится при разборе пула потоков в LCL.
Serial Kahan: Компенсация Кэхэна в одном потоке
Прежде чем лечить параллельные вычисления, давайте исправим последовательное однопоточное суммирование. Хвост из девяток после запятой портит общее впечатление от результатов работы.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 |
procedure SerialKahanSum(const Data: TDoubleDynArray; out Result: Double); var I: Integer; S, C, Y, T: Double; begin S := 0.0; C := 0.0; // Аккумулятор потерянных младших битов (компенсация) for I := 0 to High(Data) do begin Y := Data[I] - C; // Учитываем ошибку предыдущего шага T := S + Y; // Новая сумма (младшие разряды Y здесь теряются) C := (T - S) - Y; // Вычисляем, что именно отрезалось при округлении S := T; end; Result := S; end; |
Результат радует глаз:
|
1 2 3 4 5 6 7 8 |
Serial : 500005,499999999940000 -> Round: 500005 (time: 0,24 ms) Serial Kahan : 500005,500000000000000 -> Round: 500006 (time: 0,49 ms) Serial : 500005,499999999940000 -> Round: 500005 (time: 0,27 ms) Serial Kahan : 500005,500000000000000 -> Round: 500006 (time: 0,49 ms) Serial : 500005,499999999940000 -> Round: 500005 (time: 0,33 ms) Serial Kahan : 500005,500000000000000 -> Round: 500006 (time: 0,53 ms) |
Похоже на магию, но магии тут нет. Это как фокус: как только узнаешь его секрет, магия моментально исчезнет.
Допустим, в S уже лежит большое число 5 000 000.0, а в Y приходит маленькое 0.00001.
| T := S + Y; |
| процессор выравнивает порядки, отбрасывает «хвост» маленького числа и кладёт округлённый результат в T. |
| C := (T-S)-Y; |
| казалось бы, с точки зрения алгебры (S+Y)-S-Y всегда равно нулю, но в строгой арифметике IEEE 754 T-S возвращает ровно ту часть Y, которая реально «влезла» в S. Вычитая из неё исходный Y, мы получаем ошибку округления с обратным знаком (если хвост отрезался — число будет отрицательным, если округлилось вверх с запасом — положительным). |
| Y := Data[I]-C; |
| на следующей итерации эта сохранённая погрешность учитывается с обратным знаком (-C: если хвост отрезался, то добавится, если округлилось с запасом — вычтется), и как только накопленная мелочь дорастёт до младшего бита S, она честно попадёт в общую сумму. |
У классического алгоритма Кэхэна есть только одно уязвимое место. Если в данных встречаются огромные положительные и огромные отрицательные числа, которые взаимно уничтожаются в конце (например, +1e16, затем миллион единиц 1.0, а в самом конце -1e16), то при случайном порядке 1e16 в середине суммы «съест» точность сильнее, чем компенсатор C успеет переварить (для таких случаев используют улучшенный алгоритм Кэхэна-Бабушки-Ноймайера), где учитывается случай |Y| > |Sum|).
Но для неотрицательных данных (как в нашем тесте, в весах размытия Гаусса, яркости пикселей или квадратах ошибок MSE) числа только растут, и даже полный хаос индексов при компенсации Кэхэна даёт стабильный результат.
Parallel Kahan: Кэхэн в потоках (и почему он тормозит)
В начале разберём ситуацию, когда мы встраиваем компенсацию Кэхэна в нашу реализацию для TParallel:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 |
procedure ParallelKahanSum(const Data: TDoubleDynArray; out Result: Double); var D: TDoubleDynArray; Lock: TCriticalSection; Sum, Cmp: Double; begin Lock := TCriticalSection.Create; try D := Data; Sum := 0; Cmp := 0; TParallel.For(0, High(D), procedure(Index: Integer) var W, Y, T: Double; begin W := D[Index]; Lock.Enter; try Y := W - Cmp; T := Sum + Y; Cmp := (T - Sum) - Y; Sum := T; finally Lock.Leave; end; end); finally Lock.Free; end; Result := Sum; end; |
Смотрим результат:
|
1 2 3 4 5 6 7 8 9 10 11 |
Serial : 500005,499999999940000 -> Round: 500005 (time: 0,24 ms) Parallel : 500005,500000000060000 -> Round: 500006 (time: 352,15 ms) Parallel Kahan : 500005,500000000000000 -> Round: 500006 (time: 33,52 ms) Serial : 500005,499999999940000 -> Round: 500005 (time: 0,27 ms) Parallel : 500005,499999999870000 -> Round: 500005 (time: 59,64 ms) Parallel Kahan : 500005,500000000000000 -> Round: 500006 (time: 23,15 ms) Serial : 500005,499999999940000 -> Round: 500005 (time: 0,33 ms) Parallel : 500005,500000000190000 -> Round: 500006 (time: 23,32 ms) Parallel Kahan : 500005,500000000000000 -> Round: 500006 (time: 22,76 ms) |
Компенсация Кэхэна работает. Но время выполнения огорчает. Критическая секция никуда не делась, именно она тормозит все потоки, которые выстраиваются в очередь ради одной злосчастной Sum.
Именно поэтому мы добавляем в этот алгоритм разбивку на чанки.
Parallel Kahan Chunk: Объединяем скорость и точность
Чанки нужны не для того, чтобы Кэхэн «смог работать» (ему плотность индексов не важна), а исключительно ради скорости, чтобы выкинуть TCriticalSection из цикла, убрать драку потоков за общие переменные SumFinal и CompFinal и не убивать кэш процессора.
Объединяем разделы про разбивку на чанки и компенсацию Кэхэна в одну реализацию:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 |
procedure ParallelKahanChunkSum(const Data: TDoubleDynArray; out Result: Double); var NumChunks, ChunkSize, I: Integer; PartialSums: array of Double; SumFinal, CompFinal, Y, T: Double; D: TDoubleDynArray; begin D := Data; NumChunks := TThread.ProcessorCount; SetLength(PartialSums, NumChunks); ChunkSize := (High(Data) + 1 + NumChunks - 1) div NumChunks; // Каждый поток считает свой чанк локально с компенсацией Кэхена TParallel.For(0, NumChunks - 1, procedure(ChunkIdx: Integer) var Idx, StartIdx, EndIdx: Integer; LocalSum, LocalComp, LocalY, LocalT: Double; begin StartIdx := ChunkIdx * ChunkSize; EndIdx := Min(StartIdx + ChunkSize - 1, High(D)); LocalSum := 0.0; LocalComp := 0.0; for Idx := StartIdx to EndIdx do begin LocalY := D[Idx] - LocalComp; LocalT := LocalSum + LocalY; LocalComp := (LocalT - LocalSum) - LocalY; LocalSum := LocalT; end; // Пишем в свою личную ячейку - гонки и false sharing минимальны PartialSums[ChunkIdx] := LocalSum; end); // Главный поток собирает итог строго по порядку (тоже через Кэхена) SumFinal := 0.0; CompFinal := 0.0; for I := 0 to NumChunks - 1 do begin Y := PartialSums[I] - CompFinal; T := SumFinal + Y; CompFinal := (T - SumFinal) - Y; SumFinal := T; end; Result := SumFinal; end; |
Надо сказать, что гонки данных мы избежали на самом деле «случайно». Алгоритм подразумевает для каждого чанка свою переменную суммы. Но этим мы одновременно избавились от главной боли многопоточных реализаций – гонки данных, борьбы за один ресурс. Поэтому критическая секция тут не нужна. Окончательный подсчёт суммы также делается по алгоритму Кэхэна.
Если придираться до последнего бита, то при записи PartialSums[ChunkIdx] := LocalSum в самом конце работы потока теряется остаток из LocalComp (хвост размером меньше одного младшего бита LocalSum, который не успел дорасти до порога округления).
Для 99.9% задач этим можно пренебречь, так как ошибка в финальной SumFinal всё равно не превысит 1–2 младших битов.
Но если нужна абсолютная педантичность, каждый чанк должен возвращать пару (Sum, Comp) (массив записей TPartialKahan = record Sum, Comp: Double; end;), и главный поток в конце прибавляет и Partial[I].Sum, и Partial[I].Comp. Это заодно разносит элементы массива в памяти на 16 байт, снижая вероятность false sharing кэш-линий между ядрами (хотя запись там и так происходит всего один раз за весь проход).
Смотрим результат:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 |
Serial : 500005,499999999940000 -> Round: 500005 (time: 0,24 ms) Parallel : 500005,500000000060000 -> Round: 500006 (time: 352,15 ms) Parallel Kahan : 500005,500000000000000 -> Round: 500006 (time: 33,52 ms) Parallel Kahan Chunk : 500005,500000000000000 -> Round: 500006 (time: 0,29 ms) Parallel Chunk : 500005,500000000000000 -> Round: 500006 (time: 0,18 ms) Serial : 500005,499999999940000 -> Round: 500005 (time: 0,27 ms) Parallel : 500005,499999999870000 -> Round: 500005 (time: 59,64 ms) Parallel Kahan : 500005,500000000000000 -> Round: 500006 (time: 23,15 ms) Parallel Kahan Chunk : 500005,500000000000000 -> Round: 500006 (time: 0,24 ms) Parallel Chunk : 500005,500000000000000 -> Round: 500006 (time: 0,17 ms) Serial : 500005,499999999940000 -> Round: 500005 (time: 0,33 ms) Parallel : 500005,500000000190000 -> Round: 500006 (time: 23,32 ms) Parallel Kahan : 500005,500000000000000 -> Round: 500006 (time: 22,76 ms) Parallel Kahan Chunk : 500005,500000000000000 -> Round: 500006 (time: 0,28 ms) Parallel Chunk : 500005,500000000000000 -> Round: 500006 (time: 0,17 ms) |
Видим, что время выполнения упало в сотни раз, по сравнению с реализацией только алгоритмом Кэхэна. Но также видим, что реализация без Кэхэна, только чанками ещё быстрее, без потери точности.
Комментарии к результату «только чанки»
В данном тесте (Parallel Chunk) это сработало потому, что массив изначально отсортирован по возрастанию (числа одного порядка складывались рядом), но на перемешанных данных с разбросом в 6–8 порядков Parallel Chunk без Кэхэна снова начнёт терять хвост мантиссы, а связка Chunk + Kahan удержит точность и там. Поэтому для произвольных данных Кэхэн поверх чанков не помешает.
В большинстве практических задач достаточно простого разбиения на чанки без Кэхэна, если заранее отсортировать массив по возрастанию. А в идеале — нарезать границы чанков так, чтобы внутри каждого лежали числа одного порядка (с одинаковой экспонентой). Да, это требует подготовки, но такую группировку можно выполнить один раз заранее или вовсе раскладывать числа по отдельным массивам одного порядка прямо в момент их генерации.
Вместо заключения
Эксперимент полностью подтвердил нашу гипотезу: многопоточность коварна тем, что ломает не только работу с памятью, но и привычную математику. Если в коде есть вещественная редукция и пороговое округление, рано или поздно TParallel.For подкинет плавающий баг, который невозможно поймать под отладчиком при пошаговом проходе.
Вывод для практики простой: в горячих циклах обработки графики лучше сразу уходить в целочисленную арифметику (Fixed-Point), где сложение строго ассоциативно и работает в разы быстрее. А если без Double не обойтись, то резать задачу на фиксированные чанки (избавляясь заодно от тормозов критических секций) и при необходимости страховать точность компенсацией Кэхэна.
Скачать
Друзья, спасибо за внимание!
Исходник (zip) 77 Кб. Delphi XE 7, 13.0
Исполняемый файл x64 (zip) 549 Кб. Built in Delphi 13.0